
RAG para empresas: conecta Claude a tus documentos
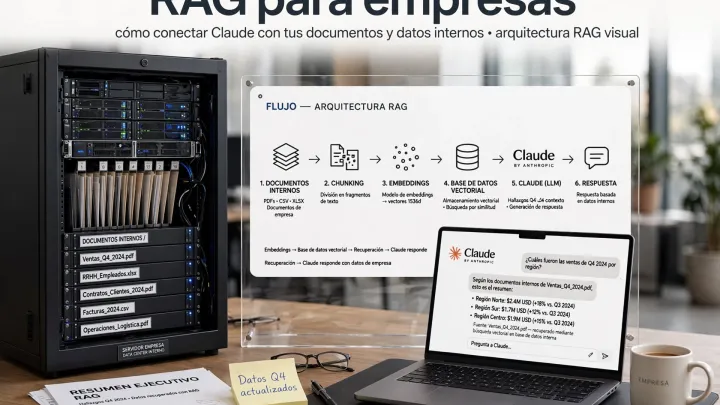
RAG (Retrieval-Augmented Generation, generación aumentada con recuperación) es la técnica que permite que un modelo como Claude responda con la documentación propia de tu empresa en lugar de con lo que recuerde de su entrenamiento general. Antes de generar la respuesta, el sistema busca en tus documentos los fragmentos relevantes para la pregunta y se los entrega al modelo como contexto. El resultado es una respuesta basada en tus manuales, tus políticas o tu catálogo, no en una aproximación genérica.
Por qué importa esto para una empresa
Un modelo de IA general no conoce tus precios actualizados, tu política de devoluciones concreta ni el procedimiento interno que solo existe en un documento de tu empresa. Sin RAG, si le preguntas, o bien no lo sabe, o bien "alucina" una respuesta plausible pero incorrecta. Con RAG, el modelo busca primero en tus documentos reales y responde a partir de ahí, con la posibilidad de citar de qué documento sale cada dato.
RAG frente a entrenar un modelo propio
| RAG | Fine-tuning (entrenar un modelo propio) | |
|---|---|---|
| Qué modifica | Nada del modelo; añade contexto en cada consulta | El comportamiento interno del modelo, de forma permanente |
| Actualizar los datos | Se actualiza el documento y ya está disponible | Requiere reentrenar, con coste y tiempo |
| Coste típico | Más bajo, sobre todo indexado y consultas | Más alto, y sube con cada actualización |
| Cuándo tiene sentido | Documentación que cambia con frecuencia, necesidad de citar la fuente | Comportamiento muy específico y estable que no depende de datos que cambian |
Para la mayoría de empresas con documentación propia (manuales, políticas, catálogos, procedimientos), RAG es la opción que compensa: más barata de mantener y más fácil de auditar, porque puedes ver de qué documento salió cada respuesta.
Cómo funciona, en cuatro pasos
Se preparan los documentos. Se dividen en fragmentos manejables (no el documento entero de una vez) y se limpian de ruido: cabeceras repetidas, pies de página, formato irrelevante.
Se indexan en una base de datos vectorial. Cada fragmento se convierte en una representación numérica que permite buscar por significado, no solo por coincidencia exacta de palabras.
Se busca el contexto relevante en cada consulta. Cuando alguien pregunta algo, el sistema busca los fragmentos más relacionados con esa pregunta, no todo el corpus.
Claude genera la respuesta con ese contexto. El modelo recibe la pregunta y los fragmentos encontrados, y responde basándose en ellos, idealmente citando de dónde sale la información.
Qué necesitas para montarlo
Documentos en un formato que se pueda procesar de forma fiable (PDF, Word, páginas web, bases de conocimiento existentes). Una base de datos vectorial, gestionada o propia, donde se indexa el contenido. Acceso a la API de Claude, con la documentación oficial de Anthropic sobre uso de herramientas y contexto ampliado como referencia técnica. Y un criterio claro sobre quién puede acceder a qué documentos, porque RAG no filtra permisos por sí solo: si el sistema tiene acceso a un documento, puede usarlo en cualquier respuesta salvo que se configure lo contrario.
Dónde encaja RAG en tu empresa
Atención al cliente que responde según tus políticas reales, no según reglas genéricas. Un asistente interno que contesta dudas de los empleados usando el manual de procedimientos, no la memoria de quien lo redactó. Un buscador conversacional sobre el catálogo de producto, que responde con las especificaciones reales en vez de una descripción aproximada. En todos los casos, el patrón es el mismo: información propia, actualizable, con la fuente citada.
Fuentes
Si quieres entender primero qué es Claude y en qué se diferencia de otros modelos, tenemos ¿qué es Claude, de Anthropic?. Si tu caso es más bien un proceso que se ejecuta solo, no solo que responde, mira agentes de IA para empresas. Para valorar tu caso, habla con nosotros sobre IA para tu empresa.
Preguntas frecuentes
¿Qué significa RAG?
Retrieval-Augmented Generation, generación aumentada con recuperación. Antes de responder, el sistema busca en tus documentos los fragmentos relevantes y se los pasa al modelo junto con la pregunta, para que conteste con esa información y no con lo que recuerde de su entrenamiento.
¿RAG es lo mismo que entrenar un modelo con mis datos (fine-tuning)?
No. El fine-tuning modifica el modelo para que se comporte distinto de forma permanente y es caro de mantener actualizado. RAG deja el modelo tal cual y le añade información externa en el momento de responder, lo que hace más fácil actualizar los datos sin reentrenar nada.
¿Mis documentos se usan para entrenar el modelo de Claude?
Depende del plan y de la configuración contratada. En el uso comercial por API, Anthropic no entrena sus modelos con los datos de los clientes por defecto. Conviene revisarlo en el contrato y en la política de privacidad vigente antes de conectar documentación sensible.
¿Necesito una base de datos especial para montar RAG?
Sí, normalmente una base de datos vectorial, que indexa los documentos de forma que se pueda buscar por significado y no solo por palabra exacta. Hay opciones gestionadas que no requieren mantener infraestructura propia.
¿RAG funciona con documentos en español?
Sí. La calidad depende más de cómo estén organizados y divididos los documentos que del idioma. Documentos largos sin estructura clara dan peores resultados que documentos bien segmentados, en cualquier idioma.